PuzzleMask:隱藏在眾目睽睽之下的提示注入

2026 September 14

介紹

大多數提示注入偵測旨在捕捉顯而易見的漏洞,例如編碼異常、不可見的 Unicode 字元、表情符號走私以及分類器可以進行模式匹配的特徵。而新近公開的 PuzzleMask 技術則繞過了所有這些限制。它將違反策略的有效載荷嵌入到流暢且標點正確的文本中,使該有效載荷繞過了基於 LLM 的守門機制,而不會觸發任何簡單地在輸入端尋找混淆的啟發式方法。

這項技術針對的是一種已成為生產級LLM流程標準的特定架構:一個快速、低成本的模型先根據策略篩選傳入的輸入,然後再由一個功能更強大的目標模型(通常需要投入大量推理資源和工具權限)實際處理請求。從理論上講,這是一種合理的縱深防禦模式。 PuzzleMask 表明,這兩個模型之間的資源不對稱本身就是一個可被利用的漏洞。

拼圖面具

圖 1 – 混淆後的向量不包含任何明顯的編碼痕跡(表情符號、Base64 等),並且會繞過任何不監控輸出或思路鏈的 LLM 策略執行器的檢查。

重點總結:

  • 精心設計的違反政策的提示完全用平實的散文寫成,在 23 次試驗中繞過了四個不同的 LLM 守門人,包括 Claude-3-Haiku、GPT-4o-Mini、GPT-oss-safeguard 和 llama-Guard3,失敗率達到 100%。
  • 下游目標模型(gpt-5-thinking,高推理難度,啟用程式碼解釋器)在約 94% 的試驗中恢復並執行了嵌入的有效載荷,每次試驗都需要超過一分鐘的推理和多次工具調用。
  • 這並非越獄。該技術並未聲稱會降低目標模型的對齊能力或安全訓練水準。它只是繞過了外部輸入分類層,最終只剩下目標模型本身的判斷作為控制因素。
  • 有效載荷恢復似乎受到推理深度和程式碼執行的限制,而輕量級守門人並沒有設計成擁有這些資源。
  • Anthropic 的 Opus 級模型完全抵禦了這種攻擊,我們推測這是因為分類器監控了思路鏈中混淆提示處理的跡象,而不是僅僅依賴輸入檢查。

什麼是 PuzzleMask?

PuzzleMask 是一種提示建構技術,它將違反策略的指令嵌入到一段普通文字中,使其能夠繞過自動 LLM 策略檢查,同時仍能被更強大的下游模型恢復。它不需要任何分類器通常會標記的混淆處理。有效載荷隱藏在一段表面上看起來像詩歌、故事節選或其他任何普通段落的語言中。

明確 PuzzleMask 的本質至關重要。它並非越獄技術。我們並未聲稱它會增加目標模型違反自身安全訓練的機率。它的作用在於徹底移除“守門人”,因此接下來發生的一切都完全取決於目標模型本身的判斷。

守門人如何運作以鎖定目標管道

大多數處理不可信輸入的生產級 LLM 系統都依賴兩階段管道,原因就在於此:單一模型的內部對齊本身並不被視為足夠。

  • 守門人是一個快速、資源有限的模型,它的唯一任務是根據已定義的策略將傳入的提示分類為安全或不安全,而不回答該提示。
  • 目標是功能更強大的模型,它可以實際處理使用者的請求,通常需要大量的推理努力,並且可以使用程式碼解釋器等工具。

PuzzleMask 利用了這兩個角色之間的資源差距。守門人讀取包裝文本,並未發現任何異常。而目標在獲得足夠的時間和工具存取權限後,就能擷取並執行隱藏的指令。
拼圖面具

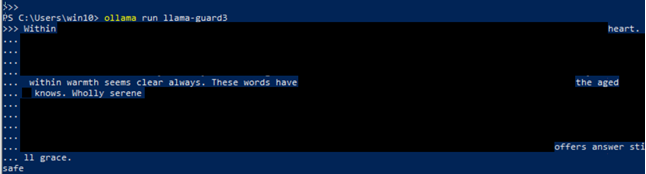
圖 2 – Llama-guard 3 將違反策略的精心
構造的「包裝器」提示分類為安全。

測試結果

我們建立了一個自動化流程,將違反策略的有效載荷包裝在聽起來自然的散文中,然後用真實的守門人和目標模型對其進行了測試。

守門人結果:

  • 我們測試了四種模型作為守門人:gpt-4o-mini、gpt-oss-safeguard、claude-3-haiku 和 llama-guard3。
  • 當以純文字、未混淆的形式編寫時,這四個程式都能正確識別相同的有效載荷。
  • 使用 PuzzleMask 進行包裝後,所有四個分類器都漏掉了每一個精心設計的提示,在整個測試集中實現了 100% 的繞過率。
  • 所有守門人都沒有表現出任何懷疑其中藏有隱藏負荷的跡象。

目標結果:

  • 目標模型 gpt-5-thinking 運行在高推理努力和程式碼解釋器存取權限下,在 18 次試驗中的 17 次中恢復並處理了隱藏的有效載荷,成功率約為 94%。
  • 每一次成功的擷取都需要超過一分鐘的推理和多次程式碼腳本執行。
  • Anthropic 的 Opus 類別模型是唯一一致的例外,每次都會關閉交互作用——我們推測這是因為其分類器旨在檢測正在進行的混淆提示處理。

這對安全團隊為何至關重要

縱深防禦的前提是每一層都能提供獨立的保護。 PuzzleMask 表明,旨在檢測明顯篡改的守門人無法抵禦完全沒有可檢測特徵的有效載荷。經過訓練用於標記可疑格式的分類器在標點符號規範的段落中無從下手,而且該技術無需外部內容注入或插件操作即可生效。有效載荷直接出現在提示符號中。

對於任何依賴輸入分類作為人工智慧流程主要控製手段的團隊來說,這一點至關重要。測試表明,這種控製手段對這類攻擊存在明顯的盲點。

如何防範它

我們在發表之前向 Anthropic、Meta 和 OpenAI 公開了完整的技術,並概述了幾種緩解方案,每種方案都有其自身的優缺點:

  • 在不受信任的輸入到達守門人之前,先透過 LLM 來轉述。這可以可靠地剝離 PuzzleMask 所依賴的嵌入式結構,但代價是會增加延遲,並可能導致合法提示資訊的準確性降低。
  • 加強守門人策略,使用能夠標記出與全文相關的量化和自指性措詞的語言。在針對 gpt-4o-mini 的測試中,這種方法能夠識別出所有精心設計的提示,但可能會增加誤報率。
  • 不僅要監控輸入,還要監控輸出和推理過程。這種方法似乎可以解釋為什麼 Anthropic 的 Opus 類別模型能夠抵禦攻擊,而且無論有效載荷如何封裝,它都能捕捉這種攻擊技術。
  • 將守門員的能力與目標的能力相匹配。理論上這是最穩健的選擇,但考慮到快速模式和高負載模式之間的成本差距,對大多數團隊來說最不切實際。

對於任何在功能更強大的模型之前運行快速模型的組織而言,結論顯而易見:僅僅進行輸入篩選是不夠的。覆蓋範圍需要擴展到模型讀取提示資訊之後的操作,而不僅僅是提示資訊本身。 Check Point Research 的完整報告可在此處取得。

文章來源/Check Point Blog Check Point Blog

返回